
Die neuen globalen Top500-Ranglisten wurden auf der SC26-Konferenz im November 2026 in Chicago vorgestellt Der schnellste Supercomputer friert die Spitze der Rangliste ein.
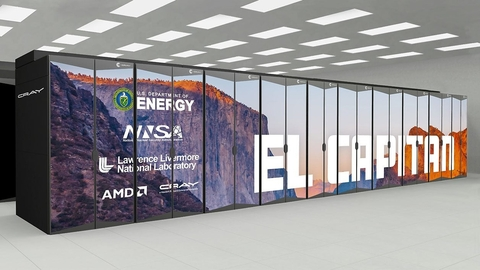
Mit nur siebenundzwanzig Neuzugängenein historischer Tiefststand, die Tabellenspitze bleibt seit Juni unverändert. Das chinesische LineShine-Systemmit Sitz in Shenzhen, behauptet mit Abstand den ersten Platz gegen Maschinen des amerikanischen Energieministeriums wie El Capitan.
Ohne amerikanische Chips verlässt sich die chinesische Architektur auf ihre eigenen Prozessoren, während Washington seine Budgets auf Hybridmaschinen umleitet, die der KI gewidmet sind, wie das neue Lux-System.
Warum bleiben die Weltranglisten im Zeitalter der KI statisch?
Die Erneuerung des TOP500 (Weltrangliste der effizientesten Supercomputer) verlangsamt sich, weil private KI-Giganten es vorziehen, ihre Server zu monetarisieren, anstatt akademische Tests durchzuführen.
Die Top Ten bleiben die gleichen wie im Juni, ebenso wie die des Green500 (Energieeffizienzranking), dominiert von Europa mit drei französischen und drei deutschen Systemen.
Hinter dieser scheinbaren Ruhe verbirgt sich eine rein finanzielle Logik : in Memphis der Colossus-Komplex von xAI und seinen 200.000 Hopper-Chips könnte drei Exaflops überschreiten, aber Elon Musk vermietet diese Leistung lieber an Anthropic, um Claude zu trainieren.
Unter der Haube wird der Kampf auch in den internen Netzwerken ausgetragen, die die Prozessoren verbinden. Wenn der InfiniBand-Standard (Hochgeschwindigkeits-Netzwerkverbindung) stattet 60,6 % der Systeme aus identifiziert, Slingshot-11-Technologie von HPE (proprietäres Low-Latency-Ethernet-Netzwerk) erfasst dank der Spitzenplatzierung 39,7 % der Gesamtleistung.
Bester Neuzugang des Herbstes: der Supercomputer Der Südkoreaner Hangang belegt mit 342,6 Petaflops den zwölften Platz dank seiner Nvidia GH200-Chips. Die Mitte des Rudels setzt ihre stille Transformation fort.
Wie dominiert China ohne amerikanische Grafikbeschleuniger?
Peking umgeht amerikanische Embargos, indem es auf die massive Architektur von LineShine setztwas 2.198 Exaflops anzeigt auf Linpackder Standard-Matrixberechnungstest, 21 % vor El Capitan.
Diese Leistung basiert auf mehr als 40.000 LingKun LX2-Prozessoren gemeinsam mit Huawei entwickeltmit 304 Arm v9.2-Kernen und 16 HBM-Speicherstapeln. Auch im HPCG-Test dominiert die Maschine (Messung des realen Speicheraustauschs) mit 22 Petaflops gegenüber 17,41 für seinen amerikanischen Rivalen gegen eine stolze Stromrechnung von 42,2 Megawatt.
Über die Aufzeichnungen hinaus bewirken diese rein zentralen Chips bereits Wunder in der wissenschaftlichen Forschung. Dank der XLSDFT-Softwareeinem Quantensimulationstool, modellierten Forscher einen Siliziumkristall mit 200 Millionen Atomen und untersuchten Festkörperbatterien und landeten damit einen Finalistenplatz beim ACM Gordon Bell Prize 2026.
Mehr als 220 Fachanwendungen laufen bereits in Shenzhen und beweisen, dass Hochleistungsrechnen möglich ist kann sich von westlichen Grafikkarten befreien. Dieser Erfolg zeigt, dass Peking in Sachen digitale Souveränität nun nicht mehr auf grünes Licht aus Washington warten will.
Was ist die amerikanische Antwort auf diese chinesische Vormachtstellung?
Washington richtet seine Strategie neu auf Mission Genesis aus um Wissenschaft und künstliche Intelligenz zu kombinieren und sich dabei auf AMD zu verlassen, das mittlerweile 40 % des Rankings ausmacht (202 Supercomputer, d. h. 14 % jährlicher Anstieg).
Das Ergebnis eines Milliardenauftrags ist der neue Supercomputer Lux betritt das Oak Ridge-Labor auf dem vierzehnten Platz. Ausgestattet mit mehr als 4.000 Instinct MI355X-Chips und 1,1 Petabyte HBM3E-Speicher erreicht es bei konventioneller Berechnung etwa 220 Petaflops, klettert im FP4 jedoch auf 40 Exaflops (leichtes Format für KI-Inferenz) zur Automatisierung von Entdeckungen.
Um den Thron der reinen Macht zurückzuerobern, setzen die Vereinigten Staaten auf das zukünftige Discovery-System voraussichtlich im Jahr 2028. Gebaut mit HPE rund um AMD Venice und MI430X-Chips, zielt es auf 5,1 bis 8,5 Exaflops in doppelter Präzision FP64weit vor dem aktuellen El Capitan und seinen 1.809 Exaflops.
Die Zukunft von HPC basiert nun auf dieser Fusion zwischen autonomer und physischer KI. Auf diesem neuen Spielfeld könnten die Schalter von Shenzhen bald sehr isoliert wirken.
