
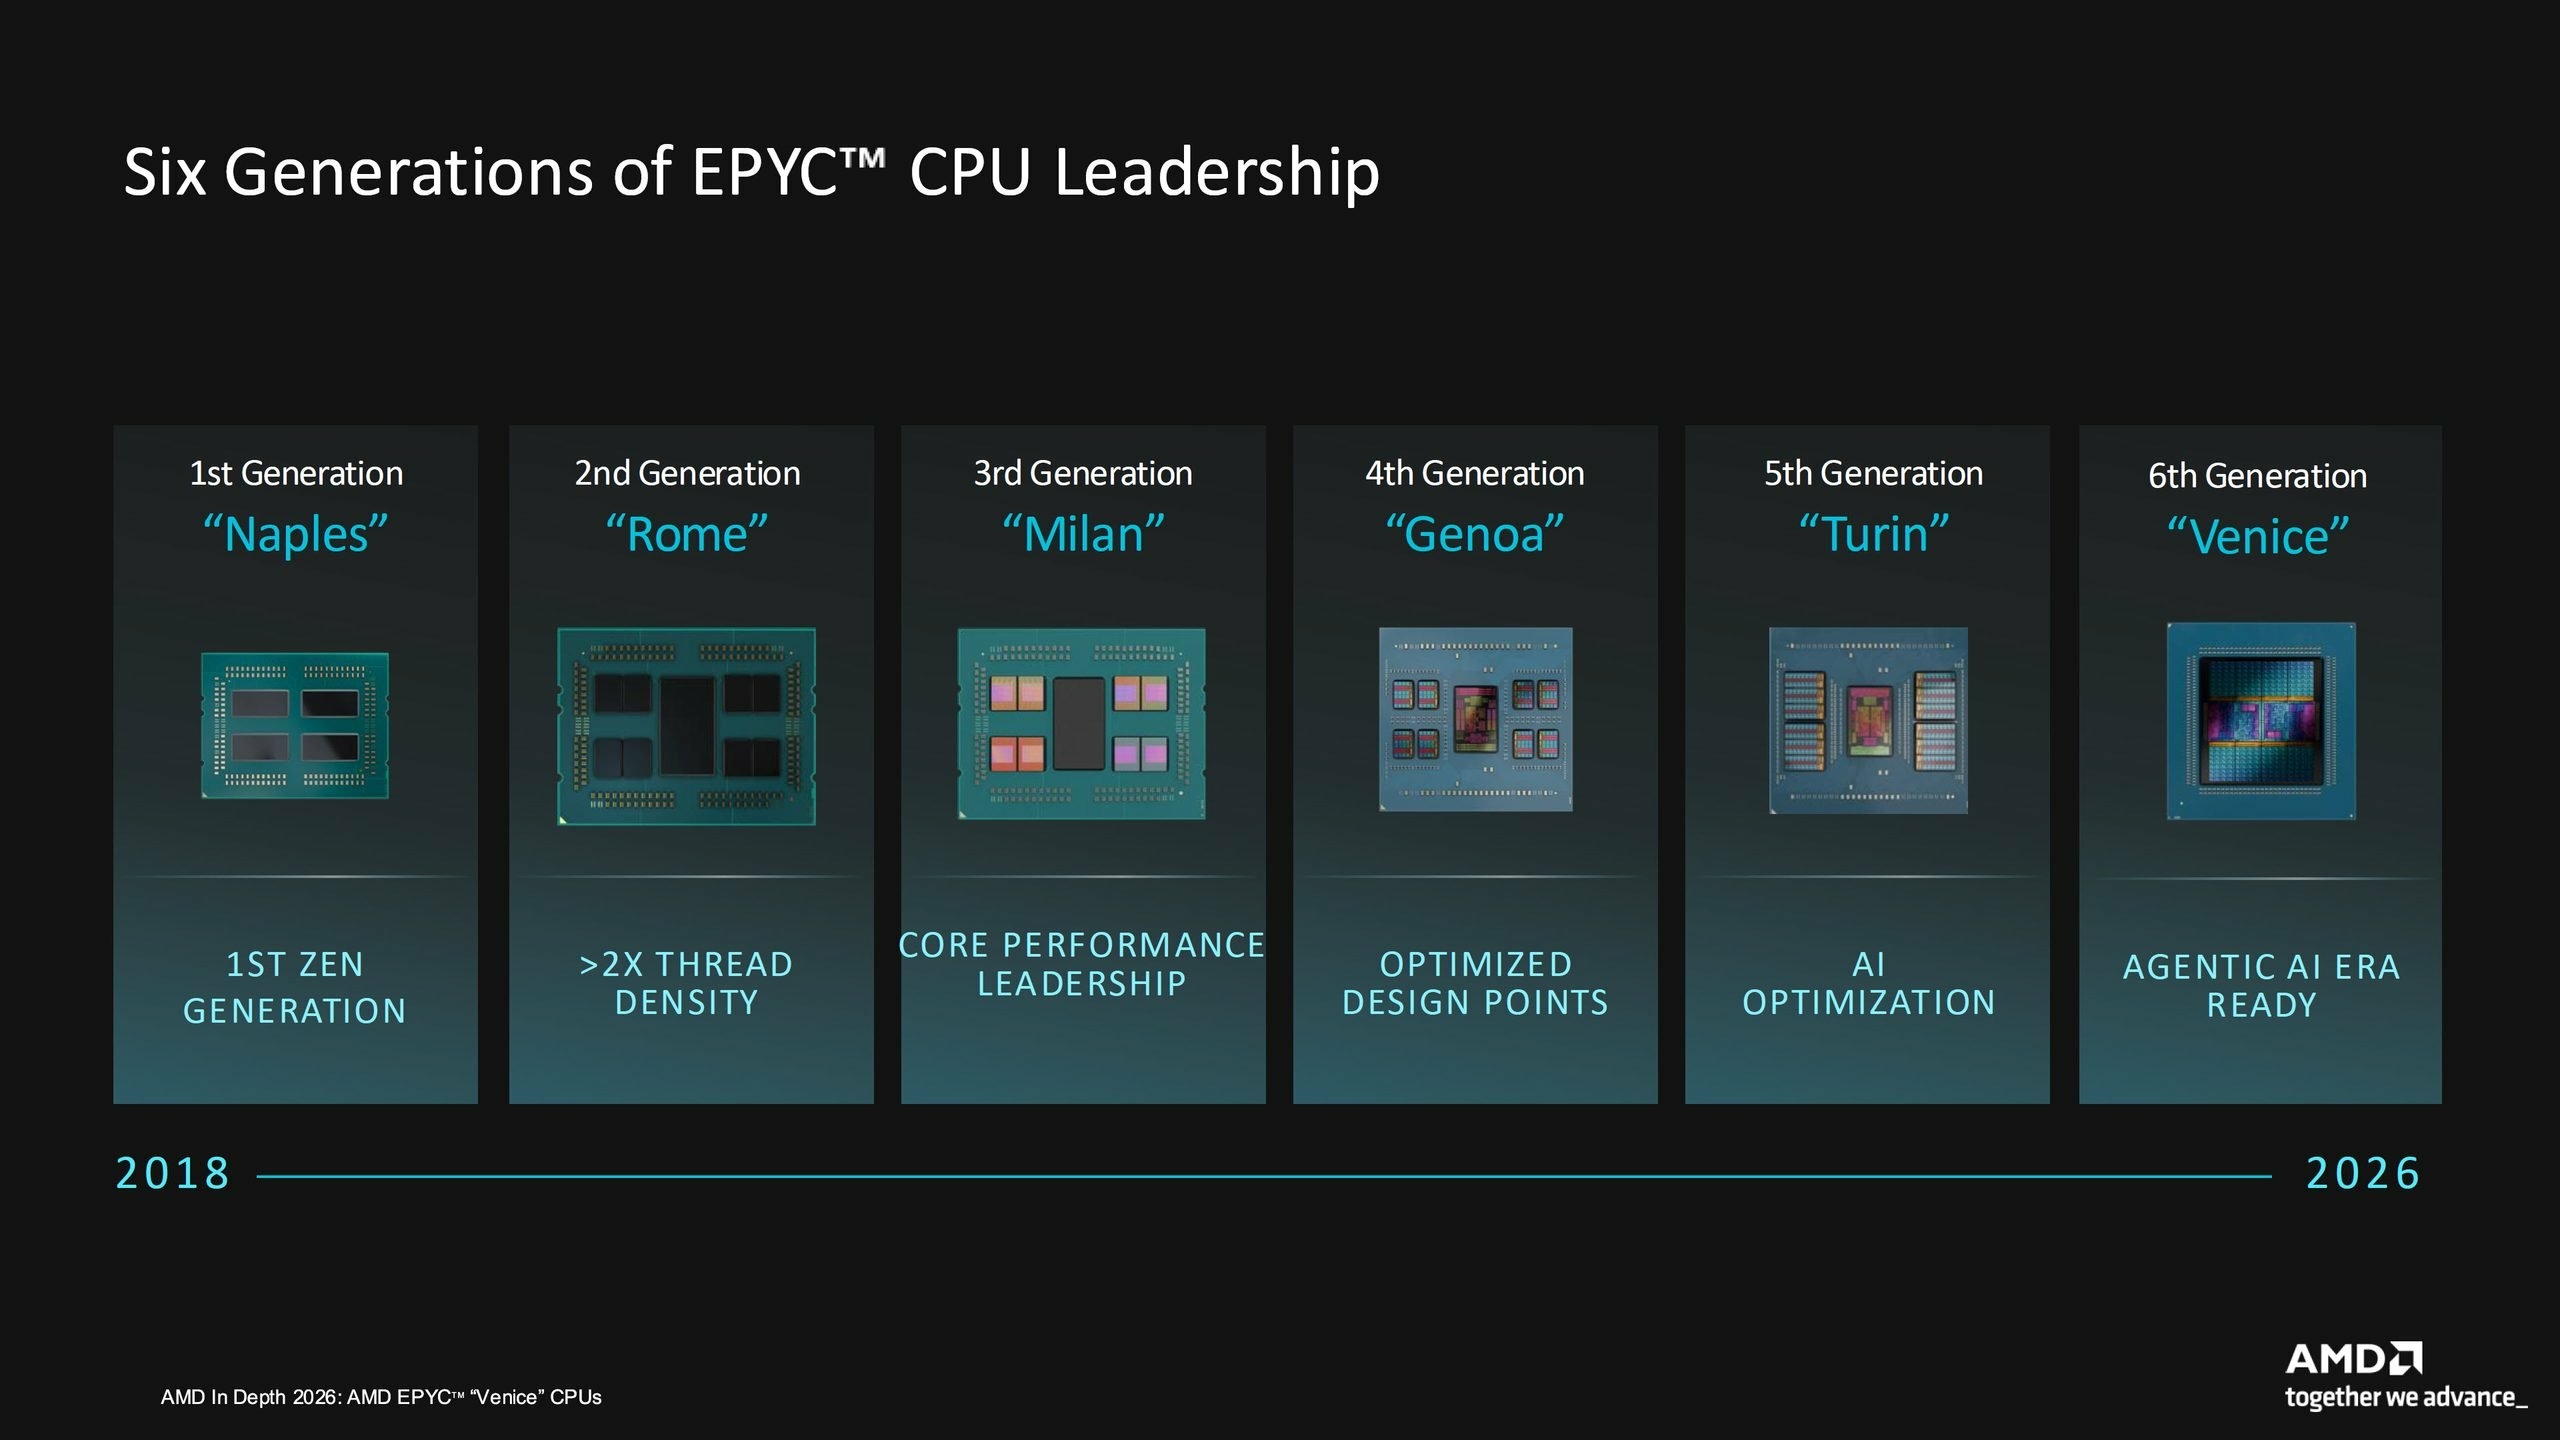
Bei einer technischen Veranstaltung in Las Vegas erläuterten AMD-Ingenieure die Geheimnisse der sechsten Generation von Unternehmensprozessoren namens Venice. Diese Chipserie mit bis zu 203 Milliarden Transistoren ist auf dem N2P-Knoten von TSMC eingraviert und definiert die Konkurrenz gegenüber Intels Xeon Granite Rapids und Nvidias Vera-Chip neu. Diese Bereitstellung erfüllt die enormen Anforderungen moderner IT-Infrastrukturen und intensiver Rechenlasten.
Wie schafft es die Mikroarchitektur des Zen 6, einen solchen Leistungsmeilenstein zu erreichen?
Die bekannt gegebenen Zahlen sind beeindruckend. Die Struktur des Zen 6 behauptet einen durchschnittlichen Anstieg der Anweisungen pro Zyklus um 27 % und steigt bei Gebühren im Zusammenhang mit künstlicher Intelligenz auf 31 %. Unter der Haube wird die Ausführung erheblich erweitert, da ein Integer-Scheduler nun auf 96 gemeinsame Einträge und 48 dedizierte Einträge aufgeteilt ist und durch eine auf 352 Einträge erweiterte physische Registertabelle unterstützt wird. Die Geschwindigkeit der Wiederherstellung nach einem Vorhersagefehler wurde klar geplant und vermeidet so kostbare unnötige Kreisläufe.
Die Vektor-Engine gewinnt an Stärke dank vier VNNI INT8-Kanälen und der nativen Ausführung des FP16-Formats in AVX-512 ohne vorherige Konvertierung. Um diesen Rechenaufruhr zu orchestrieren, hat AMD hat die mutige Entscheidung getroffen, zwei unterschiedliche Kerne zu entwerfen: eine klassische Version, die für einen Frequenzanstieg über 5 GHz ausgelegt ist, und eine dichte Version, die dank aufgeblähter Neuordnungsstrukturen eine erhöhte Speicherlatenz absorbieren kann.
Welche neuen Technologien verändern die Effizienz von Rechenzentren?
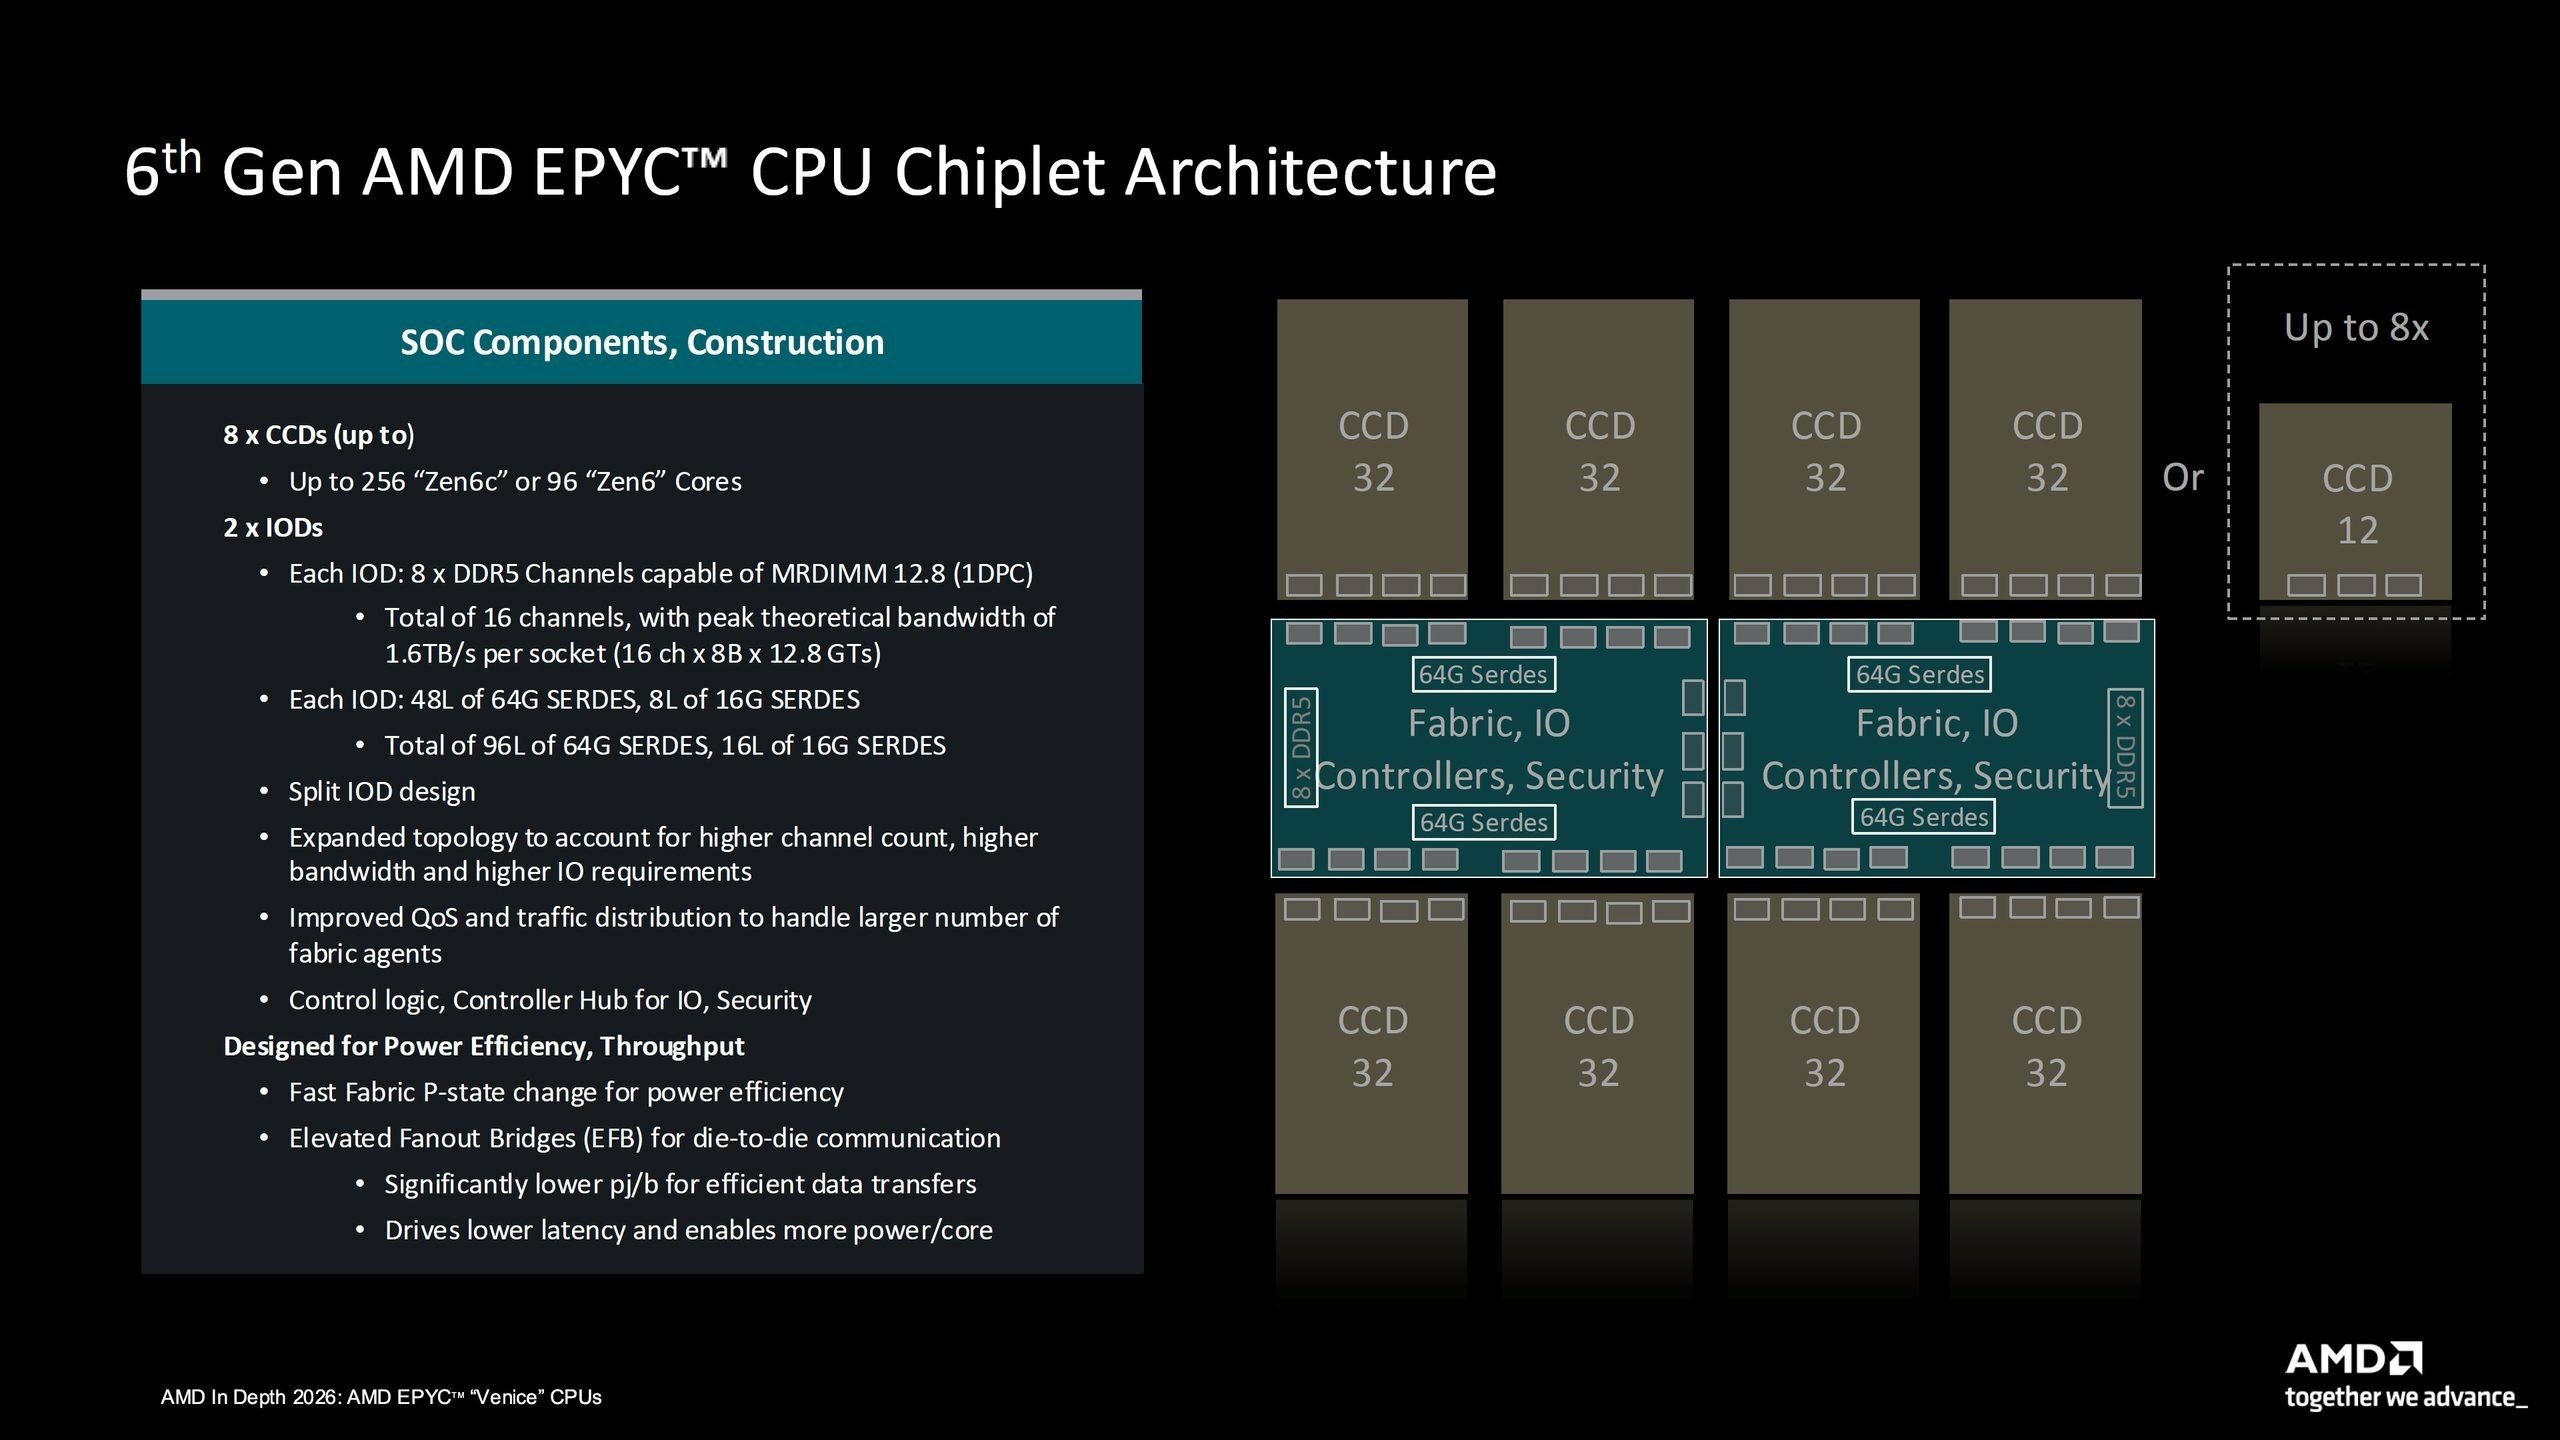
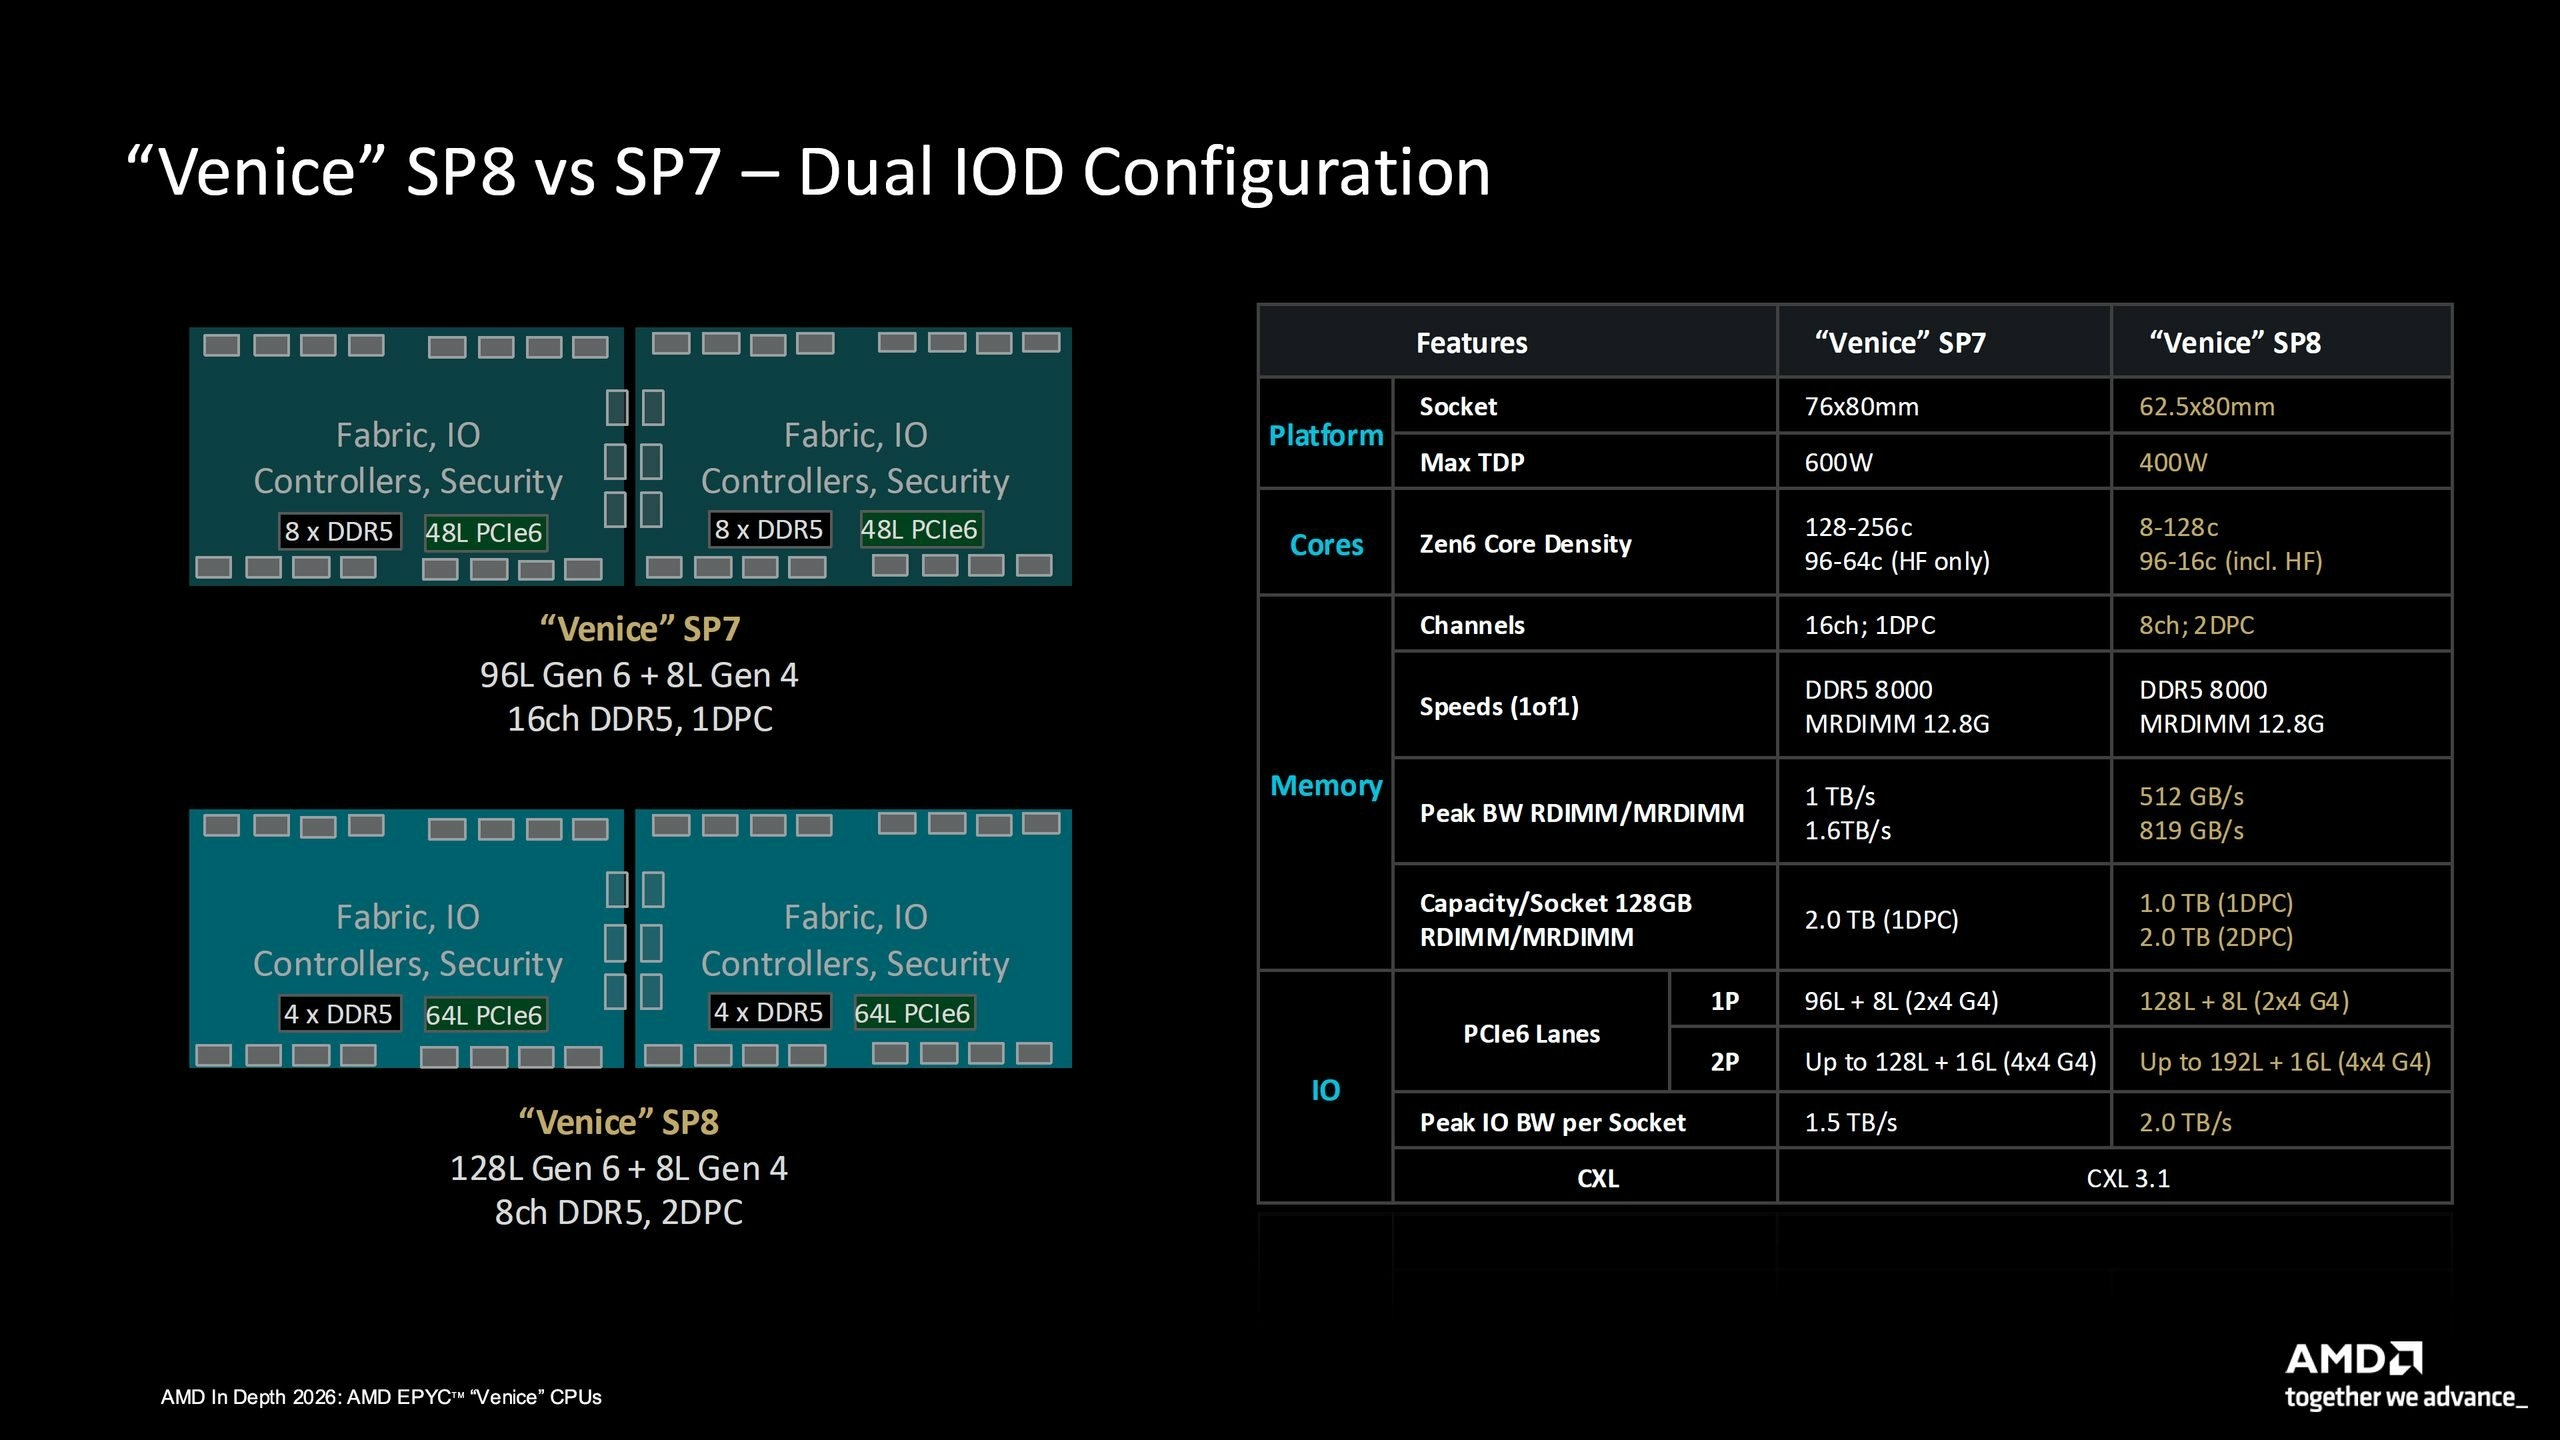
Um dieses komplexe Geflecht zu kommunizieren, führt die SP7-Plattform zwei Input-Output-Chips ein, die über ultraschnelle Verbindungsbrücken mit den Berechnungsmodulen verbunden sind. Jeder Sockel bedient bis zu sechzehn Speicherkanäle, die MRDIMMs mit 12.800 MT/s verwalten, was einen schwindelerregenden Durchsatz von 1,6 TB/s garantiert. In einem Rechenzentrum Modern gesättigt, bietet die Einführung des PCIe 6.0-Standards eine doppelte Bandbreite, die für die Bewässerung der Grafikbeschleuniger erforderlich ist.
Da die Stromrechnung zum Kernthema wird, basiert das Energiemanagement auf den UPP- und FAST-Funktionen und autorisiert denselben Prozessor schnelle Kerne für dringende Anfragen und kostengünstige Kerne für die Stapelverarbeitung zusammenzuführen. Um die exorbitanten RAM-Kosten zu amortisieren, verwendet die MEXT-Technologie ein Vorhersagemodell, mit dem RAM auf NVMe-Flash-Speicher verlagert werden kann, während 95 % des tatsächlichen Anwendungsdurchsatzes aufrechterhalten werden.
Welche Auswirkungen wird dieser Schritt nach oben auf künftige Verbraucherverarbeiter haben?
Die Weiterentwicklung des Berechnungsmoduls verändert die Situation für den einzelnen Markt radikal. Jeder Standard-Siliziumblock bietet jetzt Platz für 12 Kerne und 48 MB L3-Cache-Speicher (vorher 8 Kerne). Auf Büromaschinen wird es diese Anordnung ermöglichen, einen Zwölfkern-Chip zu entwerfen, der auf einer einzigen Komponente montiert ist, wodurch Übertragungsverzögerungen zwischen den Chips vermieden werden, die bestimmte schwere Software immer noch benachteiligen.
Diese Neuorganisation ermöglicht es, allgemeine öffentliche Versionen mit 24 Kernen ohne übermäßige Komplexität vorzustellen.
Spieler achten besonders auf die Venice-X-Version und ihr vertikales Stacking, das 144 MB Cache-Speicher pro Chip erreicht. Ein solcher ultraschneller Speicherpool, der auf einen Gaming-Prozessor angewendet wird, würde die Softwareplanung vereinfachen, indem alle Prioritätskerne in einem einzigen Cache-reichen Block zusammengefasst werden, wodurch frustrierende Kompromisse entfallen zwischen Rohfrequenz und interner Speicherkapazität.
Häufig gestellte Fragen (FAQ)
Was unterscheidet einen Standardkern von einem dichten Kern dieser Generation?
Im Gegensatz zu früheren Generationen, bei denen nur die Menge an Cache variierte, modifiziert die dichte Zen 6c-Version ihre internen Strukturen mit größeren Befehlswarteschlangen, um Remote-Speicherzugriffe besser zu tolerieren, während das klassische Modell höhere maximale Taktfrequenzen bevorzugt.
Wie senkt die MEXT-Technologie die Infrastrukturkosten?
MEXT verwendet einen Vorhersagealgorithmus, um ruhende Datenseiten auf einer schnellen SSD statt im RAM zu speichern. Das System behält nahezu die volle Rechengeschwindigkeit bei und reduziert gleichzeitig die physische Menge an RAM, die pro Server benötigt wird, um bis zur Hälfte.
Wann wird die Architektur für Consumer-Desktop-PCs verfügbar sein?
Da Servern und Enterprise Computing absolute Priorität eingeräumt wird, um die 2-Nanometer-Gravur rentabel zu machen, werden die ersten Consumer-Modelle für Desktop-PCs erst in einigen Monaten auf den Markt kommen.
